Kiến trúc DU và CU (Baseband)
Phần baseband của trạm gốc xử lý mọi thứ phía trên RF và Low-PHY: phần còn lại của lớp vật lý, các lớp MAC, RLC, PDCP, SDAP và RRC. Ở LTE, phần này thường nằm trong một khối gọi là Baseband Unit (BBU); ở 5G, nó được tách thành Distributed Unit (DU) và Centralized Unit (CU). Trang này trình bày DU và CU ở góc độ cấu trúc phần cứng và hệ thống, đối xứng với Kiến trúc Radio Unit. Thứ tự trình bày: quá trình chuyển từ BBU sang DU và CU, phân chia chức năng và yêu cầu thời gian, sơ đồ khối của DU trên server, đồng bộ thời gian tại DU, các lớp phần mềm hệ thống trên DU, CU, các nền tảng phần cứng, yêu cầu triển khai tại site và các yếu tố định cỡ.
Các mô hình tăng tốc L1 (lookaside, inline, GPU) và thư viện DPDK BBDev được trình bày ở L1 & Acceleration. Việc chạy DU và CU trong máy ảo hoặc container (SR-IOV, CPU pinning, real-time kernel) thuộc tab Virtualization, xem vRAN trên VM.
Từ BBU tới DU và CU
Ở kiến trúc LTE phổ biến, BBU đặt tại chân cột hoặc trong tủ thiết bị, chứa toàn bộ xử lý baseband của eNB và nối với RRU trên cột bằng CPRI. BBU là thiết bị chuyên dụng của từng hãng: khung máy, các card baseband và card truyền dẫn, phần mềm đóng.
NG-RAN của 5G định nghĩa gNB gồm một gNB-CU và một hoặc nhiều gNB-DU, nối với nhau qua giao diện F1 (TS 38.401). CU còn có thể tách tiếp thành CU-CP (control plane) và CU-UP (user plane), nối với nhau qua giao diện E1. O-RAN dùng cùng cách chia này với tên O-DU và O-CU, và thêm split 7.2x giữa O-DU và O-RU, xem RAN Architecture & Splits.
Việc tách DU và CU cho phép đặt hai phần ở hai nơi khác nhau theo yêu cầu thời gian của chúng, và cho phép chạy chúng trên phần cứng khác nhau, kể cả server thông dụng (commercial off-the-shelf, COTS). Thiết bị chuyên dụng kiểu BBU vẫn tồn tại ở 5G, khi đó DU và CU có thể nằm chung trong một khối.
Phân chia chức năng và yêu cầu thời gian
| DU | CU-UP | CU-CP | |
|---|---|---|---|
| Lớp giao thức | High-PHY, MAC, RLC | SDAP, PDCP cho user plane | RRC, PDCP cho control plane |
| Ràng buộc thời gian | Cứng, theo slot (0,5 ms ở SCS 30 kHz) | Mềm, cỡ ms | Mềm, theo thủ tục báo hiệu |
| Vị trí thường gặp | Tại site hoặc điểm tập trung gần site (giới hạn bởi độ trễ fronthaul) | Điểm tập trung hoặc gần UPF | Điểm tập trung, data center |
| Tải tăng theo | Số cell, băng thông, số anten và layer | Lưu lượng người dùng | Số UE và số sự kiện báo hiệu |
| Giao diện | Fronthaul tới RU, F1 tới CU | F1-U, E1, NG-U (GTP-U) | F1-C, E1, NG-C, Xn-C |
Ràng buộc thời gian là điểm khác biệt lớn nhất. DU phải xử lý xong mỗi slot trước deadline và gửi gói fronthaul đúng cửa sổ thời gian của RU, nên cần core CPU cô lập, hệ điều hành real-time và độ trễ ổn định. CU xử lý theo gói và theo bản tin, không gắn với từng slot, nên có thể chạy như một ứng dụng mạng thông thường và tập trung nhiều cell về một chỗ.
Sơ đồ khối của DU trên server
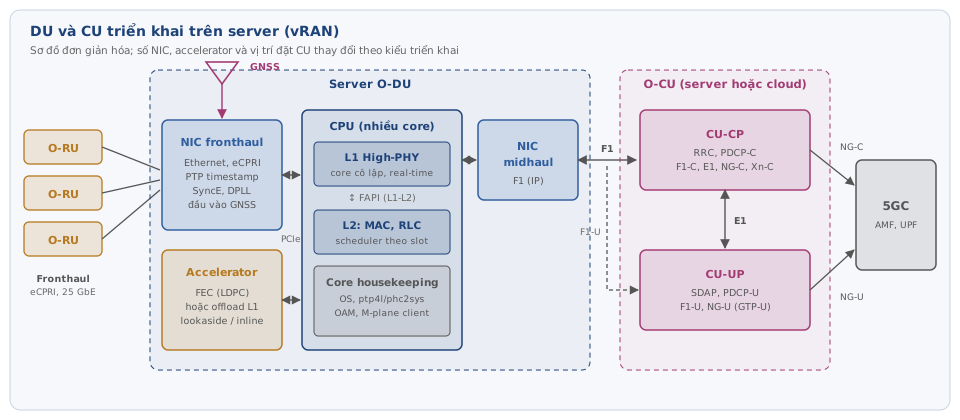
Một O-DU trên server phục vụ nhiều O-RU. CU có thể chạy trên server riêng tại điểm tập trung hoặc trên cloud.
Một DU chạy trên server COTS gồm các thành phần chính:
| Thành phần | Vai trò |
|---|---|
| CPU nhiều core | Chạy L1 High-PHY (nếu không offload toàn bộ), L2 (MAC, RLC) và phần quản lý. Các core chạy L1 và L2 được cô lập khỏi hệ điều hành |
| Accelerator | Đảm nhận phần nặng nhất của L1, thường là mã hóa và giải mã LDPC, hoặc toàn bộ High-PHY. Có thể là card PCIe hoặc khối tích hợp trong CPU |
| NIC fronthaul | Cổng Ethernet tới RU (thường 25 GbE), gắn dấu thời gian PTP bằng phần cứng, hỗ trợ SyncE và có thể có đầu vào GNSS |
| NIC midhaul | Cổng IP tới CU qua F1, có thể dùng chung NIC với fronthaul nếu đủ cổng |
| Bộ nhớ | Bộ đệm mẫu IQ và dữ liệu HARQ; băng thông bộ nhớ là một giới hạn khi số cell tăng |
Bên trong DU, L1 và L2 giao tiếp qua FAPI, giao diện do Small Cell Forum định nghĩa. FAPI tách các bản tin cấu hình (P5) khỏi các bản tin theo slot (P7), nhờ đó phần mềm L2 của một nhà cung cấp có thể chạy với L1 của nhà cung cấp khác. Vì mỗi slot L2 phải gửi quyết định lập lịch xuống L1 trước khi L1 bắt đầu xử lý, độ trễ của giao diện này nằm trên đường găng của deadline.
Phần mềm DU thường được phân core như sau: một nhóm core cô lập chạy các thread L1 theo pipeline symbol và slot, một nhóm core chạy L2 và scheduler, và các core còn lại chạy hệ điều hành, tiến trình đồng bộ (ptp4l, phc2sys), phần mềm OAM và M-plane client điều khiển RU. Các lớp phần mềm hệ thống phía dưới được tóm tắt ở mục Phần mềm hệ thống trên DU.
Đồng bộ thời gian tại DU
DU giữ vai trò trung tâm trong đồng bộ của fronthaul. Tùy cấu hình đồng bộ của O-RAN (xem Đồng bộ trong RAN), DU có thể là:
- Telecom Grandmaster (T-GM): DU lấy thời gian từ một máy thu GNSS gắn trực tiếp và phát PTP xuống RU. Đây là trường hợp của LLS-C1 khi không có nguồn thời gian từ mạng.
- Telecom Boundary Clock (T-BC): DU nhận PTP từ mạng truyền dẫn phía trên và phát lại xuống RU.
- Không tham gia: ở LLS-C3, RU nhận thời gian trực tiếp từ mạng fronthaul, DU chỉ là một client như RU.
Để làm T-GM hoặc T-BC, NIC fronthaul cần gắn dấu thời gian ở mức PHY, có bộ dao động điều chỉnh được và DPLL để lọc nhiễu pha. Ví dụ, card Intel E810 dòng Westport Channel có máy thu GNSS tích hợp và được dùng làm T-GM trong các hướng dẫn triển khai vRAN. Khi mất GNSS, DU phải duy trì thời gian trong một khoảng (holdover) nhờ bộ dao động chất lượng cao hoặc nhờ nguồn PTP và SyncE dự phòng. Phần mềm đồng bộ trên Linux được trình bày ở Linux PTP.
Phần mềm hệ thống trên DU
DU chạy trên server là nơi yêu cầu real-time của RAN chạm trực tiếp vào hệ điều hành. Bảng dưới xếp các lớp phần mềm hệ thống và chỉ tới trang trình bày từng lớp ở các tab Linux Kernel, Embedded và Virtualization:
| Lớp | Nội dung trên DU | Trang liên quan |
|---|---|---|
| Kernel real-time | Kernel PREEMPT_RT, chính sách lập lịch SCHED_FIFO cho thread L1 và L2, đo độ trễ bằng cyclictest hoặc rtla |
Real-time Linux (PREEMPT_RT) |
| Cô lập CPU | Core dành riêng cho L1, L2 và DPDK; tắt tick định kỳ; đẩy ngắt sang core housekeeping | isolcpus, nohz_full, IRQ affinity |
| Packet I/O | Fronthaul qua DPDK ở user space, bỏ qua network stack của kernel | DPDK, mmap, UIO, dma-buf |
| Accelerator | Card FEC hoặc L1 offload gắn qua PCIe, truy cập từ user space qua DPDK BBDev | L1 & Acceleration |
| Đồng bộ thời gian | ptp4l và phc2sys, máy thu GNSS cho vai trò T-GM, DPLL trên NIC, bộ dao động cho holdover |
Linux PTP, GNSS trên Linux, DPLL và đồng bộ mạng, Thạch anh và bộ dao động |
| Quản lý server | Giám sát phần cứng, bật tắt và cập nhật firmware server từ xa tại site | BMC, IPMI |
| Ảo hóa | DU trong máy ảo hoặc container: SR-IOV, ghim vCPU, huge page | vRAN trên VM, Real-time KVM tuning |
Hai lớp đầu bổ sung cho nhau: PREEMPT_RT giới hạn độ trễ từ lúc thread được đánh thức tới lúc chạy, còn cô lập CPU loại bỏ công việc khác chen vào core chạy L1 và DPDK, xem Quan hệ với CPU isolation.
CU
CU-CP xử lý báo hiệu: thiết lập và giải phóng kết nối RRC, handover, quản lý bearer, điều khiển CU-UP qua E1. CU-UP xử lý dữ liệu người dùng: mã hóa và bảo vệ toàn vẹn ở PDCP, ánh xạ QoS flow vào radio bearer ở SDAP, đóng và mở gói GTP-U trên F1-U và NG-U.
Vì không bị ràng buộc theo slot, CU thường được hiện thực như các network function cloud-native chạy trên server tại điểm tập trung hoặc data center, và một CU có thể phục vụ nhiều DU. Tách CU-UP khỏi CU-CP cho phép đặt CU-UP gần UPF hoặc gần người dùng để giảm độ trễ dữ liệu, và mở rộng CU-UP theo lưu lượng mà không cần mở rộng CU-CP. Tải của CU-UP chủ yếu là mã hóa PDCP và xử lý gói, nên hiệu năng phụ thuộc vào tập lệnh mã hóa của CPU và khả năng xử lý gói của NIC.
Các giao diện F1, E1 và NG chạy trên mạng IP và thường được bảo vệ bằng IPsec, xem IPsec.
Nền tảng phần cứng
| Hướng | Mô tả | Ví dụ |
|---|---|---|
| Baseband chuyên dụng | Khung hoặc khối của hãng thiết bị, dùng SoC hoặc ASIC riêng, phần mềm đóng | Ericsson Baseband 6648; Nokia AirScale với các card dung lượng dùng SoC ReefShark |
| Server COTS và card accelerator | Server x86 hoặc Arm, thêm card PCIe cho FEC hoặc L1 | Server x86 kèm card FEC lookaside hoặc card L1 inline |
| CPU tích hợp accelerator | Khối tăng tốc vRAN nằm trong CPU, không cần card accelerator rời | Intel Xeon thế hệ 4 có vRAN Boost (LDPC, rate matching, HARQ), Intel Xeon 6 SoC |
| GPU | L1 chạy trên GPU, dùng chung phần cứng với tải AI | Các nền tảng AI-RAN, xem AI-RAN của Nokia và Nvidia |
Baseband chuyên dụng tối ưu điện năng và dung lượng cho một hãng; server COTS cho phép tách phần cứng khỏi phần mềm và dùng chung hạ tầng với các network function khác. Xu hướng chọn silicon cho DU được phân tích trong RAN Silicon Rethink và Marvell sau Investor Day 2026.
O-RAN WG7 công bố các thiết kế phần cứng tham chiếu (white-box) cho một số kịch bản triển khai như indoor picocell và outdoor macrocell, bao gồm cả phần O-DU. Các đặc tả này mô tả kiến trúc phần cứng và yêu cầu, không bắt buộc dùng chipset cụ thể và không quy định phần mềm của O-DU, O-CU.
Yêu cầu triển khai tại site
Khi DU đặt tại site hoặc ở điểm tập trung nhỏ, điều kiện môi trường khác nhiều so với data center:
- Kích thước: tủ thiết bị tại site thường nông, nên dùng server có chiều sâu ngắn (short-depth) hoặc thiết bị dạng hộp.
- Nhiệt độ và tản nhiệt: dải nhiệt độ hoạt động rộng hơn data center, có thể không có điều hòa.
- Nguồn: nguồn -48 V DC như các thiết bị viễn thông khác (ETSI EN 300 132-2), thay cho nguồn AC.
- Tiêu chuẩn thiết bị viễn thông: nhiều nhà mạng yêu cầu thiết bị đạt NEBS (Telcordia GR-63-CORE về môi trường và cơ khí, GR-1089-CORE về EMC và an toàn điện) hoặc tiêu chuẩn ETSI tương đương.
- Ăng-ten GNSS: nếu DU là T-GM, cần lắp ăng-ten GNSS và đi cáp tới NIC, đây là một điểm hỏng cần có phương án holdover.
Định cỡ
Dung lượng cần có của một DU phụ thuộc vào:
| Yếu tố | Ảnh hưởng |
|---|---|
| Số cell và số sóng mang | Mỗi cell cần một pipeline L1 và một instance scheduler |
| Băng thông mỗi sóng mang | Số PRB, kéo theo khối lượng FFT ở RU, giải mã LDPC và ước lượng kênh ở DU |
| Số anten và số layer MIMO | Khối lượng ước lượng kênh, cân bằng và MIMO detection tăng nhanh theo số layer |
| Category của RU | Với RU Category A, precoding nằm ở DU, nên DU tính thêm phần này và fronthaul mang nhiều luồng hơn |
| Băng thông fronthaul | Số cổng và tốc độ NIC, phụ thuộc số RU, băng thông và phương pháp nén IQ |
| Mức tải | Giải mã LDPC uplink tăng theo lưu lượng, nên DU phải định cỡ theo tải đỉnh |
Thông số dung lượng mà nhà cung cấp công bố (ví dụ số cell 100 MHz 4T4R trên một server) chỉ có ý nghĩa cùng với cấu hình đi kèm: số layer, mức tải, phiên bản phần mềm và loại accelerator.
Liên quan
- Real-time Linux (PREEMPT_RT) (Linux Kernel): kernel real-time, nền của yêu cầu deadline theo slot.
- Kiến trúc Radio Unit: phần cứng phía bên kia của fronthaul.
- RAN Architecture & Splits: các khối CU, DU, RU, giao diện và functional split.
- L1 & Acceleration: chuỗi xử lý High-PHY, các mô hình tăng tốc và DPDK BBDev.
- Đồng bộ trong RAN: yêu cầu đồng bộ và cấu hình LLS của O-RAN.
- WG6: Cloudification and Orchestration: O-Cloud và AAL, đặc tả cho DU và CU chạy trên hạ tầng cloud.
- vRAN trên VM và Real-time KVM tuning: chạy DU trong máy ảo.
- DPDK: packet I/O cho fronthaul trên Linux.
- RAN Silicon Rethink: bài viết về hướng silicon cho DU.
Tài liệu tham khảo
- 3GPP TS 38.401: NG-RAN; Architecture description (gNB-CU, gNB-DU, tách CU-CP và CU-UP).
- 3GPP TS 38.473 (F1AP) và TS 38.463 (E1AP).
- Small Cell Forum: 5G FAPI: giao diện giữa L1 và L2.
- O-RAN WG7: White-box Hardware: thiết kế phần cứng tham chiếu, gồm các kịch bản indoor picocell và outdoor macrocell.
- Intel: Xeon 6 SoC for vRAN, solution brief: vRAN Boost tích hợp trong SoC.
- DPDK: Intel vRAN Boost v1 (VRB1) poll mode driver: chức năng của accelerator tích hợp trong Xeon thế hệ 4 (LDPC, rate matching, HARQ).
- OKD: About PTP: dùng Intel E810 Westport Channel làm grandmaster với GNSS.
- VMware Telco Cloud Platform RAN: cấu hình timing cho DU: DU ở chế độ T-GM với LLS-C1, nguồn dự phòng khi mất GNSS.
- Ericsson: New Ericsson baseband makes 5G easier (2020): Baseband 6648.
- Nokia: AirScale baseband và ReefShark System-on-Chip.
- ETSI EN 300 132-2: Power supply interface at the input to ICT equipment; Part 2: -48 V Direct Current (DC).
- Telcordia GR-63-CORE (NEBS: physical protection) và GR-1089-CORE (EMC and electrical safety).