Edge AI trên Linux SoC có NPU
Trang này trình bày việc chạy inference trên SoC chạy Linux có khối tăng tốc AI, ở góc độ chọn phần cứng và tích hợp phần mềm lên board. Trang lần lượt phân loại các khối tăng tốc, liệt kê một số SoC và accelerator làm ví dụ, mô tả các lớp phần mềm từ ứng dụng tới driver, trình bày runtime và toolchain của từng hãng, và cuối cùng là các điểm cần kiểm tra khi đưa model lên board. Cấu trúc bên trong NPU thuộc tab Chip & SoC, còn cách viết driver NPU thuộc tab Linux Kernel.
Các loại khối tăng tốc
Trên một board chạy Linux, phép tính của model có thể chạy trên bốn loại phần cứng. Mỗi loại khác nhau về hiệu năng, mức độ hỗ trợ operator và độ phức tạp khi tích hợp.
| Loại | Mô tả | Ưu điểm | Hạn chế |
|---|---|---|---|
| CPU | Các lõi Cortex-A, dùng lệnh SIMD (Neon) | Chạy được mọi operator, không cần toolchain riêng | Chậm nhất, chiếm CPU của ứng dụng |
| GPU | GPU tích hợp trong SoC, dùng OpenCL, Vulkan hoặc OpenGL ES | Hỗ trợ cả số thực, linh hoạt | Hiệu năng trên mỗi watt thấp hơn NPU |
| NPU tích hợp | Khối chuyên dụng nằm trong SoC | Hiệu năng cao trên mỗi watt, dùng chung DRAM với CPU | Chỉ hỗ trợ một tập operator, thường chỉ số nguyên, phụ thuộc toolchain của hãng |
| Accelerator rời | Chip AI riêng nối qua PCIe, M.2 hoặc USB | Thêm được vào SoC không có NPU, nâng cấp được | Thêm chi phí, công suất và một driver ngoài cây kernel của SoC |
NPU tích hợp là lựa chọn phổ biến khi thiết kế board mới vì không cần thêm linh kiện. Accelerator rời phù hợp khi SoC đã được chọn vì lý do khác (giá, nguồn cung, ngoại vi) nhưng không có NPU, hoặc khi cần hiệu năng cao hơn NPU tích hợp.
Ví dụ SoC và accelerator
Bảng sau liệt kê một số SoC và accelerator cho Edge AI trên Linux, kèm hiệu năng đỉnh do hãng công bố. Danh sách chỉ mang tính minh họa cho các hướng tiếp cận khác nhau, không phải danh sách đầy đủ.
| Chip | Hãng | Khối tăng tốc | Hiệu năng công bố | Toolchain chính |
|---|---|---|---|---|
| i.MX 8M Plus | NXP | NPU tích hợp, CPU 4x Cortex-A53 | 2.3 TOPS | eIQ, VX delegate cho LiteRT |
| i.MX 93 | NXP | Arm Ethos-U65 microNPU | Xem datasheet | eIQ, Vela, Ethos-U delegate |
| i.MX 95 | NXP | NPU Neutron | Xem datasheet | eIQ, neutron-converter, Neutron delegate |
| RK3588 | Rockchip | NPU 3 lõi, CPU Cortex-A76 và A55 | 6 TOPS | RKNN-Toolkit2, RKNN runtime |
| AM62A7 | Texas Instruments | DSP C7x kèm Matrix Multiply Accelerator (MMA) | 2 TOPS (AM62A3: 1 TOPS) | Processor SDK, TIDL |
| Hailo-8L, Hailo-8 | Hailo | Accelerator rời qua PCIe (ví dụ Raspberry Pi AI HAT+ cho Pi 5) | 13 TOPS, 26 TOPS | Hailo SDK |
Các board trong tab Embedded hiện chưa có NPU: RK3399 và Raspberry Pi 3B chỉ chạy inference được bằng CPU hoặc GPU. Nếu cần thử nghiệm NPU, có thể chọn board dùng một trong các SoC ở bảng trên, hoặc thêm accelerator rời qua PCIe hoặc USB.
Chưa kiểm chứng
Hiệu năng NPU của i.MX 93 và i.MX 95 chưa được đối chiếu với datasheet của NXP, nên chưa ghi vào bảng.
Các lớp phần mềm
Chạy model trên NPU cần nhiều lớp phần mềm phối hợp với nhau. Ứng dụng gọi runtime, runtime giao phần đồ thị mà NPU hỗ trợ cho một delegate hoặc execution provider, lớp này gọi thư viện user space của hãng, và thư viện đó giao tiếp với driver NPU trong kernel qua ioctl.
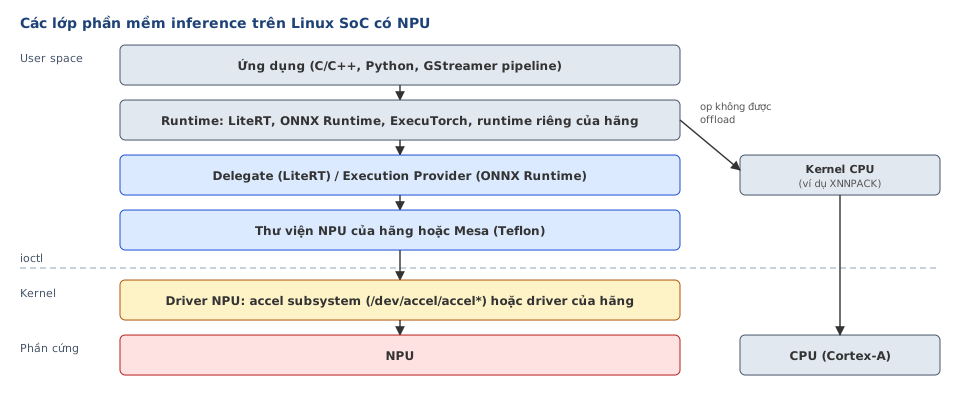
Điểm quan trọng ở lớp delegate là việc chia đồ thị (graph partitioning). Runtime chỉ giao cho NPU các operator mà delegate hỗ trợ; các operator còn lại chạy trên CPU. Mỗi lần chuyển giữa NPU và CPU, dữ liệu phải được đồng bộ, nên một model có vài operator không được hỗ trợ nằm xen giữa có thể chạy chậm hơn cả khi chạy toàn bộ trên CPU. Tài liệu i.MX của NXP lưu ý rằng LiteRT mặc định dùng XNNPACK (thư viện kernel tối ưu cho CPU), nên cần kiểm tra operator nào thực sự được đẩy xuống NPU.
Ở lớp driver có hai hướng:
- Driver và thư viện của hãng. Hãng phát hành driver kernel (thường ngoài cây kernel chính thức) cùng thư viện user space dạng binary, đóng gói sẵn trong BSP. Ví dụ, BSP cho RK3588 đã có sẵn driver RKNPU và thư viện
librknnrt.so. Hướng này hỗ trợ đầy đủ model và operator, nhưng gắn với phiên bản kernel của BSP. - Driver mainline và Mesa. Từ kernel 6.2, Linux có subsystem
acceldành riêng cho compute accelerator, xây dựng trên DRM, với device node/dev/accel/accel*. Phía user space, Mesa cung cấp Teflon, một external delegate cho LiteRT, chạy được trên hai driver: etnaviv (NPU của VeriSilicon, có trong i.MX 8M Plus và Amlogic A311D) và Rocket (NPU của Rockchip). Với i.MX 8M Plus, tài liệu Mesa yêu cầu kernel mainline từ 6.8 trở lên. Driver Rocket vào mainline ở kernel 6.18 và phần user space nằm trong Mesa 25.3; tại thời điểm merge, RK3588 là SoC duy nhất được hỗ trợ. Với hướng này, ứng dụng dùng LiteRT chạy được trên NPU qua một stack hoàn toàn mã nguồn mở.
Với dự án cần kernel mới hoặc cần cập nhật kernel lâu dài, driver mainline giảm phụ thuộc vào BSP của hãng. Đổi lại, tập operator và model được hỗ trợ trên stack mã nguồn mở thường hẹp hơn stack của hãng. Cấu trúc của accel subsystem và cách viết driver thuộc tab Linux Kernel.
Runtime và toolchain
Có hai cách đưa model lên NPU. Cách thứ nhất là dùng runtime đa nền tảng (LiteRT, ONNX Runtime) kèm delegate hoặc execution provider của hãng: ứng dụng giữ nguyên, chỉ đổi delegate khi đổi phần cứng. Cách thứ hai là dùng toolchain riêng của hãng để biên dịch model sang định dạng riêng, chạy bằng runtime riêng: thường đạt hiệu năng cao hơn nhưng ứng dụng gắn với một hãng.
| Hãng hoặc runtime | Định dạng model | Cách chạy trên accelerator | Ghi chú |
|---|---|---|---|
| LiteRT | .tflite |
Delegate, nạp dưới dạng external delegate (thư viện .so) |
Runtime phổ biến nhất trong BSP của các hãng SoC |
| ONNX Runtime | .onnx |
Execution provider, chọn theo danh sách ưu tiên, CPU là lựa chọn cuối | Nhận model xuất từ PyTorch qua ONNX |
| ExecuTorch | .pte |
Backend, ví dụ backend Ethos-U | Runtime của PyTorch cho thiết bị edge, bản 1.0 phát hành 10/2025 |
| NXP eIQ | .tflite |
VX delegate (libvx_delegate.so) cho i.MX 8, Ethos-U delegate cho i.MX 93, Neutron delegate cho i.MX 95 |
Model cho Ethos-U phải qua Vela, model cho Neutron phải qua neutron-converter trước |
| Rockchip RKNN | .rknn |
RKNN runtime, API C (rknn_api.h) và Python (RKNN-Toolkit-Lite2) |
RKNN-Toolkit2 chạy trên PC, chuyển model từ LiteRT, ONNX, PyTorch và mô phỏng trước khi chạy trên board |
| TI Processor SDK | .tflite, .onnx |
Delegate và execution provider của TI cho C7x/MMA | SDK gộp phần Linux và phần MCU+ |
Khi chọn SoC, cần đánh giá toolchain cùng lúc với phần cứng. Các câu hỏi cần trả lời trước: model cần dùng có chuyển đổi được không, bao nhiêu phần trăm operator chạy được trên NPU, toolchain có chạy trên hệ điều hành của máy build không, và BSP đi kèm dùng phiên bản kernel và LiteRT nào.
Kiểm tra khi đưa model lên board
Các bước sau giúp phát hiện sớm vấn đề khi chạy model trên NPU:
- Chạy model trên CPU của board trước để có thời gian và độ chính xác tham chiếu.
- Bật delegate hoặc execution provider của NPU, đọc log của runtime để xem đồ thị bị chia thành bao nhiêu phần và operator nào chạy trên CPU.
- Đo thời gian inference sau vài lần chạy khởi động (warm-up). Lần chạy đầu tiên có thể chậm hơn đáng kể vì một số delegate chuẩn bị hoặc biên dịch đồ thị cho NPU ở lần gọi đầu.
- So sánh độ chính xác với model float32 gốc trên cùng tập dữ liệu kiểm tra, vì quantization và cách NPU làm tròn có thể làm lệch kết quả.
- Đo toàn bộ pipeline, không chỉ thời gian inference. Tiền xử lý (đổi kích thước ảnh, chuyển định dạng màu) chạy trên CPU có thể chiếm nhiều thời gian hơn bản thân model.
Liên quan
Tài liệu tham khảo
- NXP, i.MX 8M Plus Applications Processor
- NXP, i.MX Machine Learning User's Guide (UG10166)
- Firefly, RK3588 NPU usage
- Advantech, ROM-6881 NPU (RK3588)
- Rockchip, rknn-toolkit2
- Texas Instruments, SPRAD74: Edge AI with AM62A
- Texas Instruments, Processor SDK AM62A
- CNX Software, Raspberry Pi AI HAT+ features Hailo-8L or Hailo-8 AI accelerator with up to 26 TOPS, 10/2024
- Linux kernel documentation, Introduction (Compute Accelerators)
- Phoronix, Compute Accelerator Subsystem Being Introduced For Linux 6.2
- Mesa documentation, TensorFlow Lite delegate (Teflon)
- Phoronix, Rockchip NPU Driver "Rocket" Expected By Linux 6.18, Mesa 25.3 Brings User-Space Code
- ONNX Runtime, Execution Providers
- PyTorch, Introducing ExecuTorch 1.0, 10/2025