Tổng quan về Edge AI
Edge AI là việc chạy model học máy (machine learning) ngay trên thiết bị nhúng, nơi dữ liệu được tạo ra, thay vì gửi dữ liệu lên server hoặc cloud để xử lý. Mục này tiếp cận Edge AI từ phía triển khai: model đã được huấn luyện sẵn, việc cần làm là chọn phần cứng, chuyển đổi model và chạy nó trên board với giới hạn về bộ nhớ, năng lượng và thời gian đáp ứng. Trang này lần lượt trình bày lý do chạy inference tại thiết bị, hai nhóm phần cứng chính, quy trình đưa model xuống thiết bị, các khái niệm dùng chung trong mục, sau đó liệt kê các trang trong mục Edge AI.
Inference tại thiết bị
Vòng đời của một model gồm hai giai đoạn. Giai đoạn huấn luyện (training) tìm ra trọng số (weight) của model từ dữ liệu, cần nhiều tài nguyên tính toán và thường chạy trên GPU ở server. Giai đoạn suy luận (inference) dùng model đã huấn luyện để xử lý dữ liệu mới. Edge AI trong mục này chỉ bàn về inference; việc huấn luyện vẫn diễn ra trên máy phát triển hoặc cloud.
Chạy inference ngay trên thiết bị được chọn vì các lý do sau:
- Độ trễ. Kết quả có ngay tại chỗ, không phụ thuộc thời gian truyền qua mạng. Điều này cần thiết cho các vòng điều khiển và các ứng dụng thị giác cần phản hồi trong vài chục mili giây.
- Băng thông. Thiết bị chỉ gửi kết quả (ví dụ "có người trong khung hình") thay vì gửi luồng video hoặc âm thanh thô.
- Quyền riêng tư. Dữ liệu nhạy cảm như hình ảnh và giọng nói không rời khỏi thiết bị.
- Hoạt động khi mất kết nối. Thiết bị vẫn ra quyết định được khi không có mạng.
- Năng lượng. Với node chạy pin, model trên MCU lọc dữ liệu tại chỗ để chỉ bật radio khi có sự kiện cần báo, thay vì truyền liên tục.
Đổi lại, thiết bị edge có ít bộ nhớ và năng lực tính toán hơn nhiều so với server. Phần lớn công việc trong Edge AI là làm cho model vừa với phần cứng: giảm kích thước model, giảm độ chính xác số học, và chuyển phần tính toán nặng sang khối tăng tốc chuyên dụng.
Hai nhóm phần cứng
Mục này chia phần cứng Edge AI thành hai nhóm theo loại chip chạy model. Hai nhóm khác nhau về hệ điều hành, dung lượng bộ nhớ và cỡ model chạy được, nên công cụ và quy trình cũng khác nhau.
| Tiêu chí | Linux SoC có NPU | MCU (TinyML) |
|---|---|---|
| Hệ điều hành | Linux (Yocto, Buildroot, distro của hãng) | Bare-metal hoặc RTOS |
| Bộ nhớ | DRAM ngoài, từ hàng trăm MB tới vài GB | SRAM và flash trên chip, từ vài chục KB tới vài MB |
| Khối tăng tốc | NPU tích hợp trong SoC, GPU, hoặc accelerator rời qua PCIe/M.2 | Lệnh SIMD hoặc vector của CPU (DSP extension, Helium), một số dòng có microNPU |
| Hiệu năng công bố | Vài TOPS tới vài chục TOPS (int8) | Vài trăm GOPS ở các dòng có NPU, thấp hơn nhiều với CPU thuần |
| Ứng dụng điển hình | Nhận dạng và phát hiện vật thể trên video, xử lý nhiều luồng camera | Phát hiện từ khóa (keyword spotting), phát hiện bất thường từ cảm biến rung, phân loại ảnh độ phân giải thấp |
| Runtime điển hình | LiteRT, ONNX Runtime, ExecuTorch, SDK của hãng | LiteRT for Microcontrollers, ExecuTorch, công cụ sinh code của hãng |
| Ví dụ | NXP i.MX 8M Plus (2.3 TOPS), Rockchip RK3588 (6 TOPS), TI AM62A7 (2 TOPS) | MCU Cortex-M4/M7/M55, ESP32-S3, STM32N6 (Neural-ART, 600 GOPS) |
Các con số TOPS trong bảng là giá trị đỉnh do hãng công bố. TI lưu ý rằng TOPS không phản ánh đúng hiệu năng thực tế, vì thời gian inference còn phụ thuộc kiến trúc accelerator và cấu trúc của từng model. Việc so sánh phần cứng nên dựa trên thời gian chạy của chính model cần dùng.
Hai nhóm này có thể cùng tồn tại trên một sản phẩm. Ví dụ, một MCU chạy model nhỏ để phát hiện sự kiện liên tục với dòng tiêu thụ thấp, và chỉ đánh thức SoC chạy Linux khi cần chạy model lớn hơn. Cách MCU và SoC phối hợp trên board xem MCU trong hệ thống Linux.
Quy trình đưa model xuống thiết bị
Dù chạy trên SoC hay MCU, quy trình triển khai đều gồm các bước tương tự nhau. Phần lớn các bước chạy trên máy phát triển; thiết bị chỉ nhận model đã được chuyển đổi.
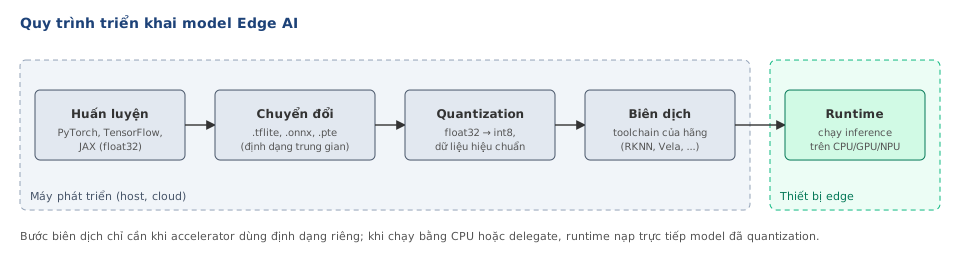
- Huấn luyện model bằng framework như PyTorch, TensorFlow hoặc JAX. Trọng số thường ở dạng số thực 32-bit (float32).
- Chuyển đổi model sang định dạng mà runtime trên thiết bị đọc được, ví dụ
.tflitecho LiteRT,.onnxcho ONNX Runtime,.ptecho ExecuTorch. - Quantization: đổi trọng số và activation từ float32 sang số nguyên 8-bit (int8). Bước này cần một tập dữ liệu đại diện để hiệu chuẩn khoảng giá trị của từng tensor.
- Biên dịch cho accelerator khi accelerator dùng định dạng riêng, ví dụ RKNN-Toolkit2 sinh file
.rknncho NPU của Rockchip, Vela sinh command stream cho Arm Ethos-U. - Chạy model bằng runtime trên thiết bị, đo thời gian inference, mức dùng bộ nhớ và độ chính xác so với model gốc.
Bước 3 quan trọng với cả hai nhóm phần cứng. Theo tài liệu LiteRT, quantization toàn bộ sang số nguyên làm model nhỏ đi khoảng 4 lần và tăng tốc từ 3 lần trở lên, đồng thời là điều kiện để chạy được trên các accelerator chỉ hỗ trợ số nguyên và trên MCU. Nếu độ chính xác giảm quá nhiều sau quantization, có thể dùng quantization-aware training, tức là mô phỏng sai số quantization ngay trong quá trình huấn luyện.
Khái niệm dùng chung
Các trang trong mục dùng một số thuật ngữ sau:
| Thuật ngữ | Ý nghĩa |
|---|---|
| NPU (neural processing unit) | Khối phần cứng chuyên tính các phép toán của mạng neural, chủ yếu là nhân ma trận và tích chập trên số nguyên. Mỗi hãng đặt tên riêng: Neutron (NXP), Neural-ART (ST), Ethos (Arm) |
| TOPS, GOPS | Số nghìn tỷ (tera) hoặc tỷ (giga) phép toán mỗi giây, thường tính cho int8, mỗi phép nhân cộng (multiply-accumulate, MAC) tính là hai phép toán |
| Runtime | Thư viện nạp model và thực thi các phép toán (operator) trên thiết bị |
| Delegate, execution provider | Cơ chế để runtime giao một phần đồ thị model cho accelerator; phần không được hỗ trợ chạy trên CPU. LiteRT gọi là delegate, ONNX Runtime gọi là execution provider |
| Operator coverage | Tập operator mà accelerator hỗ trợ. Operator nằm ngoài tập này sẽ chạy trên CPU và có thể làm chậm toàn bộ model |
| Quantization | Biểu diễn trọng số và activation bằng số nguyên ít bit hơn (thường là int8) để giảm bộ nhớ và tăng tốc |
TensorFlow Lite đã được Google đổi tên thành LiteRT (Lite Runtime) từ tháng 9 năm 2024; nhiều tài liệu và BSP của hãng vẫn dùng tên cũ. Các trang trong mục dùng tên LiteRT, và ghi tên cũ khi trích dẫn tên file hoặc thư viện.
Các trang trong mục Edge AI
| Trang | Nội dung | Trạng thái |
|---|---|---|
| Edge AI trên Linux SoC có NPU | Các loại accelerator, ví dụ SoC, lớp phần mềm từ runtime tới driver, toolchain của hãng | Đang viết |
| TinyML trên MCU | Ràng buộc của MCU, LiteRT for Microcontrollers, CMSIS-NN, MCU có microNPU, đánh giá hiệu năng | Đang viết |
| Quantization và tối ưu model | Post-training quantization, quantization-aware training, pruning, kiểm tra độ chính xác | Chưa viết |
| Đưa runtime vào build system | Tích hợp runtime và thư viện NPU vào Yocto, Buildroot | Chưa viết |
| Lab: triển khai model trên board | Ví dụ đầy đủ từ model tới thiết bị trên một board cụ thể | Chưa viết |
Liên quan
- MCU Overview và MCU trong hệ thống Linux
- Edge Gateway: gateway IoT là một vị trí thường đặt inference
- Hardware Platforms: các board chạy Linux
- Yocto và Buildroot
Tài liệu tham khảo
- Google for Developers, TensorFlow Lite is now LiteRT, 09/2024
- Google AI Edge, Post-training quantization
- NXP, i.MX 8M Plus Applications Processor
- Firefly, RK3588 NPU usage
- Texas Instruments, SPRAD74: Edge AI with AM62A
- STMicroelectronics, STM32N6 Series
- ONNX Runtime, Execution Providers