Pipeline
Kỹ thuật chồng lấp việc thực thi nhiều lệnh bằng cách chia mỗi lệnh thành các giai đoạn (fetch, decode, execute, memory, write-back).
Bản ôn tập
Trang này là bản ôn tập ngắn gọn, sẽ mở rộng sau (ví dụ tách riêng superscalar/out-of-order).
1. Ý tưởng cơ bản
Giống dây chuyền lắp ráp: thay vì làm xong hoàn toàn một lệnh rồi mới bắt đầu lệnh sau, CPU chia lệnh thành các giai đoạn và cho mỗi giai đoạn xử lý một lệnh khác nhau trong cùng một chu kỳ.
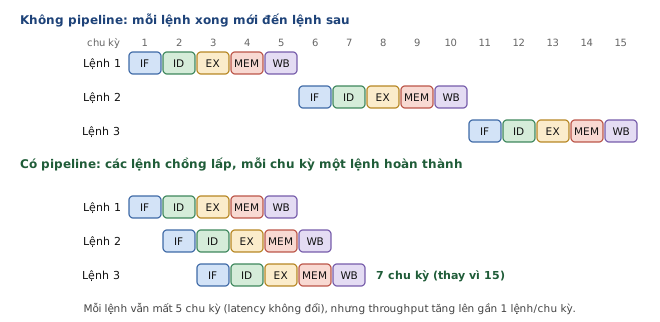
- Pipeline tăng throughput (số lệnh hoàn thành mỗi đơn vị thời gian), không giảm latency của từng lệnh.
- Với pipeline k giai đoạn cân bằng và không có hazard: CPI → 1, speedup lý tưởng ≈ k.
- Thực tế speedup thấp hơn vì hazard (mục 3) và vì các giai đoạn không đều nhau (chu kỳ clock bị giới hạn bởi giai đoạn chậm nhất).
2. Pipeline cổ điển 5 giai đoạn
| Giai đoạn | Viết tắt | Làm gì | Tài nguyên chính |
|---|---|---|---|
| Instruction Fetch | IF | Đọc lệnh tại PC, tính PC + 4 | PC, I-cache |
| Instruction Decode | ID | Giải mã, đọc thanh ghi nguồn | Register file |
| Execute | EX | Tính toán, tính địa chỉ, so sánh nhánh | ALU |
| Memory | MEM | Đọc/ghi bộ nhớ (chỉ lw/sw) |
D-cache |
| Write-back | WB | Ghi kết quả vào thanh ghi đích | Register file |
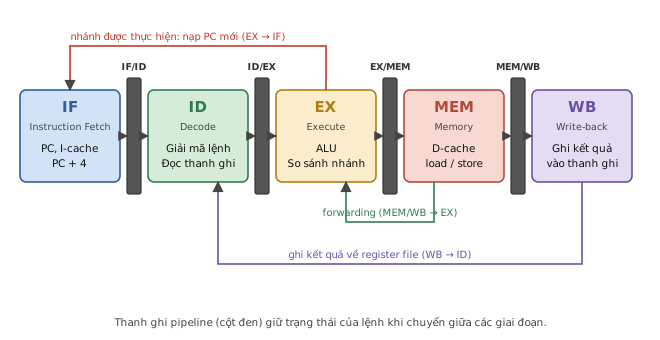
- Thanh ghi pipeline (IF/ID, ID/EX, EX/MEM, MEM/WB) giữ toàn bộ trạng thái của lệnh khi chuyển sang giai đoạn kế tiếp, nhờ đó mỗi giai đoạn xử lý một lệnh độc lập.
- Có ba đường quay ngược: ghi thanh ghi (WB → ID), nạp PC mới khi rẽ nhánh (EX → IF) và forwarding (MEM/WB, EX/MEM → EX).
- Trên RISC-V, lệnh có độ dài đều và chỉ
load/storetruy cập bộ nhớ nên rất hợp với pipeline này (xem RISC-V).
3. Hazard
Hazard là tình huống khiến lệnh kế tiếp không thể chạy ngay ở chu kỳ tiếp theo.
| Loại | Nguyên nhân | Ví dụ | Cách xử lý |
|---|---|---|---|
| Structural | Hai lệnh cần cùng một tài nguyên trong cùng chu kỳ | IF và MEM cùng truy cập một bộ nhớ duy nhất | Tách I-cache / D-cache, thêm cổng đọc/ghi |
| Data | Lệnh sau cần kết quả của lệnh trước chưa có | RAW: add x1,... rồi sub x4, x1,... |
Forwarding, stall |
| Control | Chưa biết lệnh kế là lệnh nào khi gặp nhánh | beq, jal, jalr |
Branch prediction, flush |
Về data hazard, ba dạng là RAW (đọc sau ghi), WAR và WAW. Trong pipeline in-order 5 giai đoạn chỉ RAW gây vấn đề; WAR và WAW xuất hiện khi thực thi out-of-order (mục 5).
Data hazard: forwarding và stall
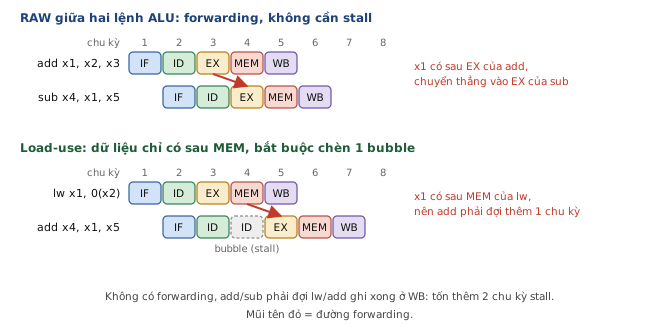
- Stall (bubble): chèn chu kỳ trống cho đến khi kết quả sẵn sàng. Không có forwarding, lệnh sau phải chờ lệnh trước ghi xong ở WB, tốn thêm 2 chu kỳ.
- Forwarding (bypassing): đưa kết quả từ đầu ra EX hoặc MEM thẳng về đầu vào EX, không cần đợi WB.
- Load-use: kết quả của
lwchỉ có sau MEM nên dù có forwarding vẫn phải stall 1 chu kỳ. Compiler thường xếp lại lệnh để lấp chỗ trống này.
Control hazard
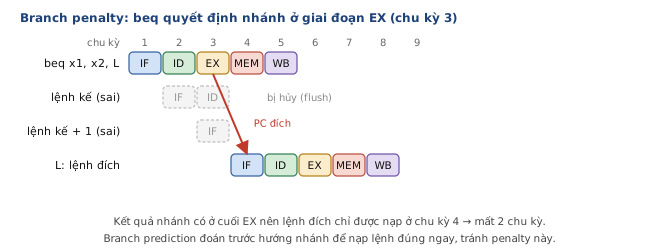
Nhánh được quyết định ở EX nên khi đó pipeline đã nạp thêm 2 lệnh phía sau. Nếu nhánh được thực hiện, 2 lệnh này bị hủy (flush) và lệnh đích mới được nạp: tốn 2 chu kỳ (branch penalty).
4. Branch prediction
Pipeline càng sâu thì branch penalty càng lớn, nên CPU đoán trước hướng của nhánh và nạp lệnh theo dự đoán. Đoán sai thì flush, đoán đúng thì không mất chu kỳ nào.
| Loại | Cách hoạt động | Ghi chú |
|---|---|---|
| Static | Quy tắc cố định: luôn not-taken, hoặc nhánh lùi (vòng lặp) taken, nhánh tiến not-taken | Không cần phần cứng lưu lịch sử |
| Dynamic 1-bit | Nhớ kết quả lần trước của nhánh | Đoán sai 2 lần mỗi vòng lặp (lúc thoát và lúc vào lại) |
| Dynamic 2-bit | Bộ đếm bão hòa 4 trạng thái, đoán sai 2 lần liên tiếp mới đổi dự đoán | Phổ biến, xử lý vòng lặp tốt |
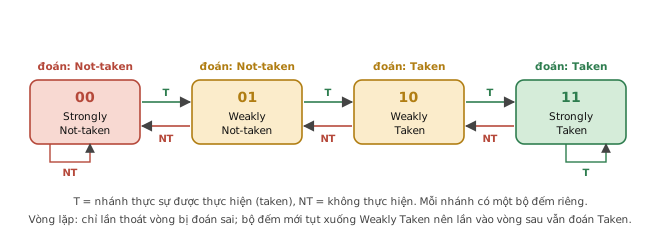
- Bảng bộ đếm được đánh chỉ mục bằng một phần địa chỉ lệnh nhánh (PC).
- BTB (Branch Target Buffer) lưu địa chỉ đích để biết nạp lệnh ở đâu ngay từ giai đoạn IF, không cần đợi giải mã.
- CPU hiện đại dùng predictor phức tạp hơn (dùng lịch sử toàn cục, TAGE, perceptron), vượt phạm vi bản ôn tập này.
5. Superscalar và out-of-order
Superscalar
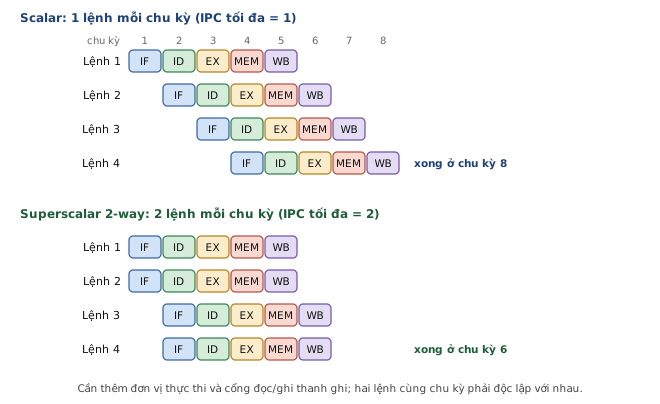
Superscalar nhân đôi (hoặc hơn) số đường xử lý để issue nhiều lệnh mỗi chu kỳ. Chỉ số hiệu năng chuyển từ CPI sang IPC (instructions per cycle) và IPC có thể lớn hơn 1.
In-order và out-of-order
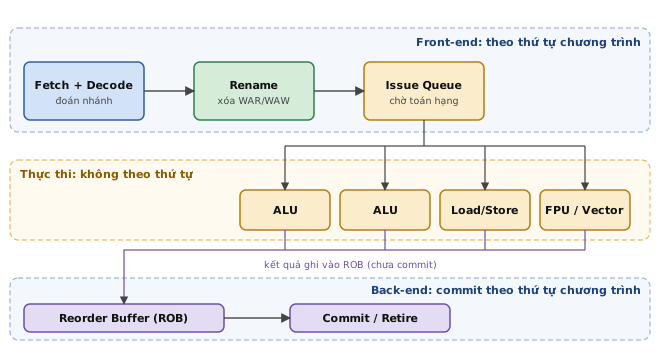
Pipeline in-order phải dừng cả hàng khi một lệnh bị stall (ví dụ cache miss). Out-of-order (OoO) cho phép các lệnh phía sau, nếu không phụ thuộc, chạy trước trong lúc lệnh bị chặn đang chờ.
| Thành phần | Vai trò |
|---|---|
| Register renaming | Ánh xạ thanh ghi kiến trúc sang thanh ghi vật lý để loại bỏ hazard WAR/WAW |
| Issue queue | Giữ lệnh đã giải mã, phát lệnh nào có đủ toán hạng cho đơn vị thực thi |
| ROB (Reorder Buffer) | Giữ kết quả tạm thời, bảo đảm lệnh commit theo đúng thứ tự chương trình |
Nhờ commit theo thứ tự, ngoại lệ và đoán nhánh sai vẫn được xử lý đúng (hủy các lệnh chưa commit). Với phần mềm, CPU trông như vẫn chạy tuần tự.
6. Tóm tắt
| Khái niệm | Vấn đề nó giải quyết |
|---|---|
| Pipeline | Tăng throughput bằng cách chồng lấp các lệnh |
| Forwarding / stall | Data hazard (RAW) |
| Tách I-cache / D-cache | Structural hazard |
| Branch prediction | Control hazard, branch penalty |
| Superscalar | Đạt IPC > 1 |
| Out-of-order + renaming + ROB | Tận dụng thời gian chờ, giữ đúng thứ tự commit |
Liên quan
- Cache và Memory Hierarchy: nguồn chính của stall ở giai đoạn IF và MEM.
- RISC-V: ISA đơn giản, thuận lợi cho pipeline.
- RTL / HDL: hiện thực pipeline ở mức RTL.