AI-RAN Overview
AI-RAN là tên gọi chung cho các hướng đưa trí tuệ nhân tạo và học máy (AI/ML) vào mạng truy nhập vô tuyến: dùng AI để vận hành và tối ưu RAN, chạy RAN và tải AI trên cùng hạ tầng tính toán, và dùng RAN làm nền cho các ứng dụng AI ở biên mạng. Trang này tổng hợp các hướng đó và chỉ tới các trang chi tiết đã có, theo thứ tự: ba hướng của AI-RAN, AI được đặt ở những tầng nào trong RAN, chuẩn hóa ở 3GPP (AI/ML cho NG-RAN và cho giao diện vô tuyến), chuẩn hóa ở O-RAN, hướng dùng chung hạ tầng tính toán, tác động tới hiện thực, rồi hiện trạng. Các bài viết theo thời điểm về sản phẩm và thị trường nằm ở mục "Liên quan".
Ba hướng của AI-RAN
AI-RAN Alliance, liên minh công nghiệp ra mắt tại MWC Barcelona tháng 2/2024, chia AI-RAN thành ba hướng tương ứng với ba nhóm làm việc:
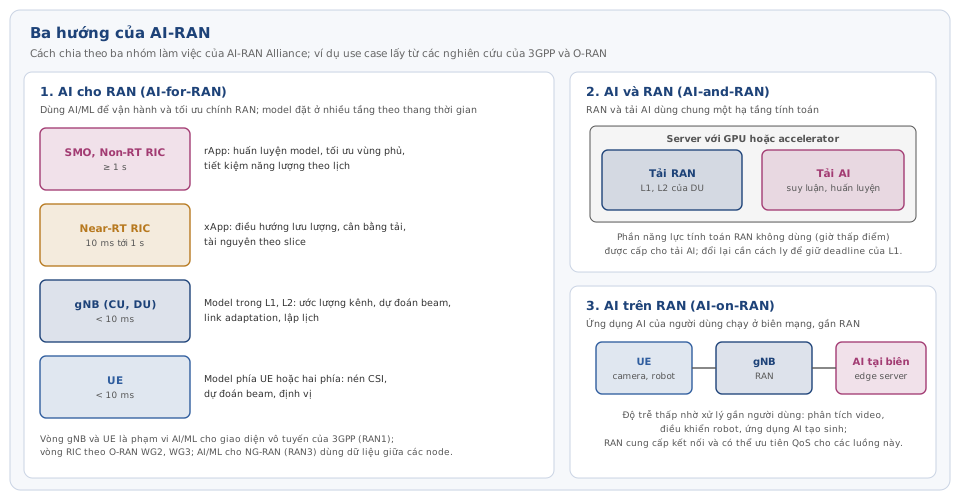
AI cho RAN đặt model ở nhiều tầng theo thang thời gian; AI và RAN dùng chung hạ tầng tính toán; AI trên RAN đưa ứng dụng AI của người dùng tới biên mạng.
| Hướng | Câu hỏi | Ví dụ |
|---|---|---|
| AI cho RAN (AI-for-RAN) | Dùng AI/ML để RAN hoạt động tốt hơn như thế nào? | Ước lượng kênh, dự đoán beam, nén CSI, điều hướng lưu lượng, tiết kiệm năng lượng |
| AI và RAN (AI-and-RAN) | RAN và tải AI có thể dùng chung hạ tầng tính toán không? | DU chạy trên server GPU, phần năng lực không dùng cho RAN được cấp cho tải AI |
| AI trên RAN (AI-on-RAN) | RAN phục vụ các ứng dụng AI ở biên mạng ra sao? | Phân tích video, điều khiển robot, suy luận AI gần người dùng với độ trễ thấp |
Ba hướng này độc lập ở mức nguyên tắc nhưng thường được trình bày cùng nhau, vì hạ tầng GPU (hướng thứ hai) vừa là nơi chạy model của hướng thứ nhất, vừa là nơi chạy ứng dụng của hướng thứ ba. Hướng thứ nhất là phần được chuẩn hóa nhiều nhất ở 3GPP và O-RAN; hai hướng còn lại chủ yếu do các nhà cung cấp và nhà mạng thúc đẩy.
AI cho RAN: AI nằm ở đâu
Theo cách chia vòng điều khiển của O-RAN, model AI có thể đặt ở bốn tầng, khác nhau về thang thời gian và dữ liệu sẵn có:
| Tầng | Thang thời gian | Dữ liệu | Ví dụ use case | Trang chi tiết |
|---|---|---|---|---|
| SMO, Non-RT RIC (rApp) | Từ 1 s trở lên | Số liệu hiệu năng, cấu hình, dữ liệu ngoài RAN | Huấn luyện model, tối ưu vùng phủ, tiết kiệm năng lượng theo lịch | RIC |
| Near-RT RIC (xApp) | 10 ms tới 1 s | Số liệu theo cell, slice, UE qua E2 | Điều hướng lưu lượng, cân bằng tải, chia tài nguyên theo slice | RIC |
| gNB (CU, DU) | Dưới 10 ms | Mẫu tín hiệu, CSI, trạng thái HARQ, hàng đợi | Ước lượng kênh, dự đoán beam, link adaptation, lập lịch | L1 & Acceleration, MAC Scheduler |
| UE | Dưới 10 ms | Phép đo của UE | Nén CSI, dự đoán beam, định vị | Mục chuẩn hóa ở dưới |
Hai tầng trên dùng giao diện mở của O-RAN (A1, E2, O1) nên ứng dụng AI có thể đến từ bên thứ ba. Hai tầng dưới nằm trong phần mềm của gNB và UE; muốn hai phía phối hợp (ví dụ model ở UE nén CSI, model ở gNB giải nén) thì phải được 3GPP chuẩn hóa.
Chuẩn hóa ở 3GPP
AI/ML cho NG-RAN
Nhóm RAN3 nghiên cứu AI/ML ở mức node và giao diện giữa các node trong Rel-17, kết quả ghi trong TR 37.817 với ba use case: tiết kiệm năng lượng mạng, cân bằng tải và tối ưu di động. Nghiên cứu này không chuẩn hóa model mà chuẩn hóa việc thu thập và trao đổi dữ liệu giữa các node (qua Xn, F1) để model của từng nhà cung cấp có đầu vào, ví dụ dự báo tải của cell lân cận. Rel-18 chuyển kết quả này thành work item chuẩn hóa (NR_AIML_NGRAN), trong đó có chỉ số Energy Cost để các node trao đổi thông tin về mức tiêu thụ năng lượng.
AI/ML cho giao diện vô tuyến
Nhóm RAN1 nghiên cứu AI/ML cho giao diện vô tuyến NR trong Rel-18, kết quả ghi trong TR 38.843, với ba use case:
| Use case | Ý tưởng |
|---|---|
| Cải tiến phản hồi CSI | Nén CSI bằng model hai phía (encoder ở UE, decoder ở gNB) để báo kênh chi tiết hơn với ít bit hơn; dự đoán CSI theo thời gian bằng model phía UE |
| Quản lý beam | Dự đoán beam tốt nhất trong một tập lớn từ phép đo trên một tập nhỏ (theo không gian), hoặc từ các phép đo trong quá khứ (theo thời gian), giảm chi phí quét beam |
| Cải thiện độ chính xác định vị | Dùng model để định vị từ đặc trưng kênh, có ích trong môi trường nhiều vật cản |
Nghiên cứu này cũng xác định các khái niệm chung cho mọi use case, xếp vào một khung (framework) AI/ML:
- Vị trí model: model một phía (chỉ ở UE hoặc chỉ ở mạng) và model hai phía (UE và mạng phối hợp, như nén CSI). Model hai phía khó chuẩn hóa và kiểm thử hơn vì hai nửa model có thể đến từ hai nhà cung cấp khác nhau.
- Quản lý vòng đời (life cycle management): thu thập dữ liệu, huấn luyện, định danh và triển khai model, theo dõi chất lượng khi chạy, chuyển đổi model, và quay về thuật toán không dùng AI khi model hoạt động kém.
Rel-19 bắt đầu phần chuẩn hóa: khung AI/ML chung, quản lý beam và định vị được đưa vào đặc tả, còn phần CSI (dự đoán và nén) tiếp tục ở mức nghiên cứu, cùng với bài toán kiểm thử model hai phía. Hướng 6G đặt AI là một phần của thiết kế ngay từ đầu (AI-native), xem 6G Roadmap.
Chuẩn hóa ở O-RAN
O-RAN tập trung vào hai tầng trên của bảng ở mục trước:
- Quy trình AI/ML (WG2): báo cáo kỹ thuật mô tả vòng đời model trong kiến trúc O-RAN, từ thu thập dữ liệu, huấn luyện ở Non-RT RIC tới triển khai suy luận ở Non-RT RIC, Near-RT RIC hoặc E2 node.
- Giao diện hỗ trợ AI/ML: dịch vụ A1-ML để quản lý model dùng trong Near-RT RIC, dịch vụ dữ liệu và AI/ML qua R1 cho rApp, dữ liệu số liệu qua E2SM-KPM cho xApp.
Chi tiết nằm ở RAN Intelligent Controller và WG2.
AI và RAN dùng chung hạ tầng tính toán
Lập luận của hướng này dựa trên hai quan sát: tải của RAN thay đổi mạnh theo giờ trong ngày, và phần cứng DU được định cỡ theo tải đỉnh, nên phần lớn thời gian còn dư năng lực tính toán. Nếu DU chạy trên GPU, phần dư đó có thể được cấp cho tải AI (suy luận cho ứng dụng của nhà mạng hoặc bán cho khách hàng), biến một khoản chi phí thành nguồn doanh thu.
Hướng này kéo theo các câu hỏi kỹ thuật chưa có câu trả lời thống nhất:
- Hiệu quả năng lượng và chi phí: GPU có hiệu năng cao và lập trình linh hoạt, nhưng so với ASIC chuyên dụng cho L1, điện năng và giá thành trên mỗi cell vẫn là điểm tranh luận, xem L1 & Acceleration.
- Cách ly thời gian thực: tải AI không được làm L1 trễ deadline theo slot. Việc chia GPU giữa RAN và AI cần cơ chế cách ly tương tự như cô lập CPU cho DU.
- Vị trí đặt: GPU tập trung ở hub hoặc edge phù hợp với Centralized RAN và Cloud RAN hơn là đặt tại từng site, xem Các mô hình triển khai RAN.
Các nhà cung cấp đang đi theo những hướng khác nhau; các bài viết theo thời điểm ở mục "Liên quan" phân tích lựa chọn của từng hãng.
Tác động tới hiện thực
- Đường dữ liệu. Model cần dữ liệu huấn luyện và dữ liệu đầu vào khi chạy. gNB phải xuất số liệu, trace hoặc mẫu tín hiệu với tần suất và định dạng phù hợp mà không làm chậm đường xử lý theo slot.
- Ngân sách thời gian. Suy luận trong L1 hoặc trong scheduler phải nằm gọn trong ngân sách của mỗi slot (0,5 ms ở subcarrier spacing 30 kHz) và có thời gian chạy ổn định, giống mọi khối khác của DU.
- Quản lý model trên thiết bị. DU và UE phải lưu, nạp, cập nhật và gỡ model, quản lý phiên bản, và có cơ chế quay về thuật toán truyền thống khi model hoạt động kém.
- Kiểm thử. Hiệu năng của model phụ thuộc dữ liệu, nên kết quả kiểm thử trong phòng thí nghiệm không bảo đảm hiệu năng ngoài thực địa; model hai phía còn khó kiểm thử tương thích giữa các nhà cung cấp.
- Bảo mật. Model và dữ liệu huấn luyện là bề mặt tấn công mới (đầu độc dữ liệu, đánh cắp model), xem WG11: Security.
Hiện trạng
AI-RAN Alliance ra mắt tháng 2/2024 với khoảng mười thành viên sáng lập gồm các nhà cung cấp thiết bị và chip (Ericsson, Nokia, Samsung, NVIDIA, Arm), nhà cung cấp cloud (Microsoft, AWS), nhà mạng (SoftBank, T-Mobile) và giới nghiên cứu (Northeastern University, DeepSig); đến tháng 7/2025 liên minh công bố hơn 100 thành viên. Ở 3GPP, AI/ML cho NG-RAN đã được chuẩn hóa từ Rel-18, và AI/ML cho giao diện vô tuyến bắt đầu được chuẩn hóa ở Rel-19.
Liên quan
- RAN Intelligent Controller: xApp, rApp, giao diện E2, A1, R1, nơi đặt AI ở tầng near-real-time và non-real-time.
- WG2: Non-RT RIC and A1: quy trình AI/ML và dịch vụ A1-ML của O-RAN.
- L1 & Acceleration: các mô hình tăng tốc L1, gồm GPU.
- MAC Scheduler: vòng điều khiển real-time trong DU, nơi AI có thể hỗ trợ link adaptation và lập lịch.
- MIMO & Beamforming và Reference Signals & CSI: quản lý beam và phản hồi CSI, hai use case AI/ML của 3GPP.
- Các mô hình triển khai RAN: Centralized RAN và Cloud RAN, môi trường phù hợp cho hạ tầng GPU dùng chung.
- 6G Roadmap: AI-native trong lộ trình 6G.
- AI-RAN của Nokia và Nvidia: bài viết theo thời điểm về RAN trên GPU.
- RAN Silicon Rethink: bài viết về lựa chọn GPU hay ASIC cho DU.
Tài liệu tham khảo
- 3GPP TR 37.817: Study on enhancement for data collection for NR and EN-DC (AI/ML cho NG-RAN, Rel-17).
- 3GPP TR 38.843: Study on Artificial Intelligence (AI)/Machine Learning (ML) for NR air interface (Rel-18).
- 3GPP: Finding AI in 3GPP: tổng quan các hoạt động AI/ML trong 3GPP.
- 3GPP: AI/ML for NR air interface: tóm tắt nghiên cứu Rel-18 và phạm vi Rel-19.
- 3GPP RAN3 leadership: RAN3 Rel-18: AI/ML cho NG-RAN trong Rel-18, chỉ số Energy Cost.
- whatthespec: TR 38.843: phiên bản và phạm vi của TR 38.843.
- IEEE 802.11-25/1478r1: AI/ML activities in 3GPP: tóm tắt use case Rel-18 và phạm vi Rel-19.
- TelecomTV: AI-RAN Alliance launches at MWC24: ra mắt, thành viên sáng lập và ba nhóm làm việc.
- RCR Wireless: AI-RAN Alliance kicks off to integrate AI into cellular technology.
- Business Wire (07/2025): AI-RAN Alliance surpasses 100 members.